23/10/2026 · VietTechies · Biên tập
Ngày 30 tháng 3 năm 2010, Bram Cohen, người tạo ra BitTorrent, đăng một bài viết ngắn giải thích cách patience diff tránh ghép nhầm các dòng khi so sánh mã nguồn. Khi bạn thêm một hàm mới vào đầu tệp mã nguồn và xóa một hàm đã lỗi thời ở cuối tệp, các công cụ diff thông thường có thể ghép các dòng theo cách gây hiểu nhầm. Thay vì thể hiện rõ một phần được thêm và một phần bị xóa, thuật toán so sánh lại ghép những dòng chỉ có dấu ngoặc nhọn đóng và những dòng trống giữa các hàm hoàn toàn không liên quan, khiến mọi hàm còn lại trông như đều bị sửa đến biến dạng.
Thuật toán diff mặc định của Git là một biến thể của thuật toán Eugene Myers, tìm dãy con chung dài nhất (Longest Common Subsequence, viết tắt là LCS). Mục tiêu của thuật toán LCS thuần túy là về số lượng: tìm dãy dòng trùng nhau dài nhất giữa hai văn bản để bản vá tạo ra có tổng số thao tác chỉnh sửa ít nhất. Với một thuật toán giải bài toán này, dòng chỉ có một dấu ngoặc nhọn đóng cũng là một cặp khớp hợp lệ như dòng khai báo một hàm riêng biệt. Khi các khối mã đổi thứ tự, việc ghép những dòng khuôn mẫu lặp đi lặp lại ấy tạo ra các bản vá tuy có số thao tác chỉnh sửa tối thiểu về mặt kỹ thuật nhưng lại rối mắt, khó hiểu với người đọc duyệt mã.
Khi dấu ngoặc khớp nhau quá dễ
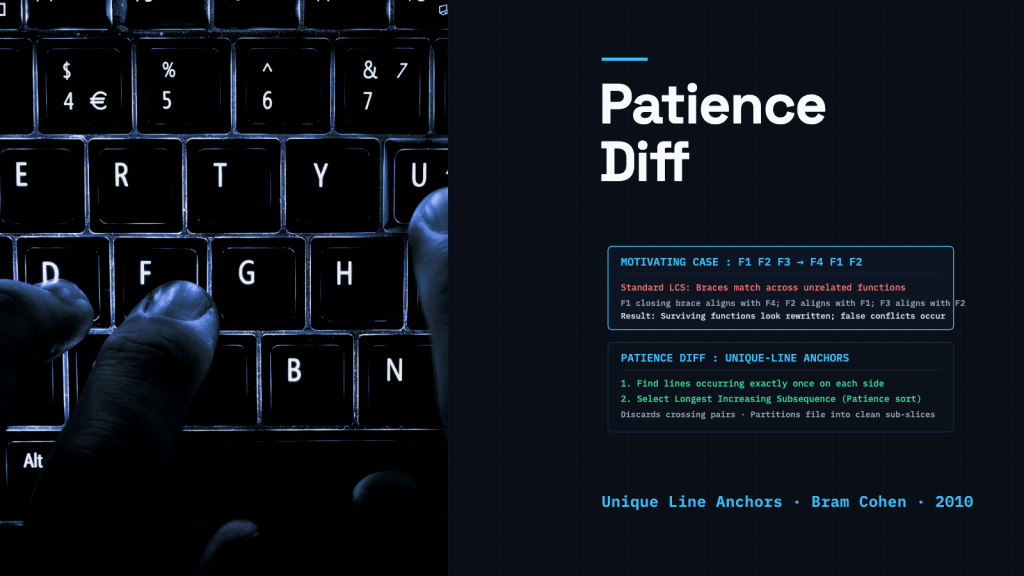
Cohen minh họa vấn đề bằng một trình tự đơn giản: hình dung một tệp chứa các hàm F1, F2 và F3, sau khi cập nhật thì thành F4, F1 và F2. Nhìn vào thay đổi, lập trình viên thấy ngay F4 được thêm vào đầu và F3 bị bỏ ở cuối, còn F1 và F2 vẫn nguyên vẹn. Thế nhưng công cụ diff tự động chỉ so sánh từng dòng mà không hiểu cấu trúc chương trình.
Vì các hàm có những dòng dấu ngoặc nhọn mở, dấu ngoặc nhọn đóng và dòng trống phân cách giống hệt nhau, phép so sánh dựa trên LCS có thể ghép các dòng khuôn mẫu của F1 với F4, của F2 với F1, và của F3 với F2. Thay vì thể hiện một phần thêm và một phần xóa, kết quả diff lại cho thấy mọi hàm trong tệp đều đã thay đổi. Khi lập trình viên hợp nhất các thay đổi được thực hiện đồng thời trên chính những hàm đó, cách ghép lệch này có thể gây xung đột hợp nhất, dù lẽ ra công cụ có thể tự động hợp nhất mà không gặp xung đột.
Lấy những dòng đặc trưng làm điểm neo
Patience diff, cách tiếp cận Cohen mô tả, xuất phát từ một nhận định khác: người đọc không coi mọi dòng đều như nhau. Những dòng như }, return; hay dòng trống có thể lặp lại nhiều lần trong cùng một tệp. Ngược lại, những dòng chung chỉ xuất hiện một lần trong mỗi bên có nhiều khả năng trở thành mốc đối chiếu có ý nghĩa hơn. Một dòng khai báo hàm hoặc khởi tạo biến ít gặp thường chỉ xuất hiện đúng một lần trong toàn bộ tệp.
Theo bài phân tích năm 2017 của James Coglan, patience diff tìm trong từng vùng những dòng xuất hiện đúng một lần ở mỗi bên. Quy trình Cohen sửa lại năm 2010 trước hết ghép các dòng giống hệt nhau ở đầu và cuối, rồi mới tìm những dòng chung chỉ xuất hiện một lần trong vùng còn lại. Các dòng lặp bị bỏ qua trong lượt tìm kiếm ban đầu này. Bằng cách tách riêng những dòng chung duy nhất ấy, thuật toán chọn được các mốc có nhiều khả năng chứa nội dung có ý nghĩa hơn những dấu câu lặp lại.
Patience sorting và các cặp khớp không giao nhau
Chỉ tìm được những dòng xuất hiện một lần ở cả hai bên vẫn chưa đủ, vì thứ tự dòng có thể thay đổi. Nếu một hàm chuyển từ cuối tệp lên đầu, các đường nối những dòng duy nhất của hàm với dòng tương ứng ở bên kia sẽ cắt qua các đường nối khác. Để những cặp dòng này tạo thành một dãy con chung, vị trí của các dòng phải tăng dần trong cả hai văn bản.
Để chọn tập điểm neo hợp lệ lớn nhất mà các đường nối không giao nhau, patience diff mượn một kỹ thuật từ patience sorting, một thuật toán bắt nguồn từ trò chơi bài, có liên hệ với solitaire. Sau khi sắp các cặp ứng viên theo vị trí trong tệp gốc, thuật toán tìm dãy con tăng dài nhất trong dãy vị trí tương ứng ở tệp mới. Bước này loại các cặp khớp có đường nối giao nhau, giữ lại một chuỗi điểm neo theo đúng thứ tự, chia cả hai tệp thành những phần nhỏ hơn, độc lập với nhau.
Quy tắc kinh nghiệm, phương án dự phòng và giới hạn thực tế
Trong bài viết năm 2010, Cohen làm rõ một giới hạn quan trọng khi áp dụng vào thực tế. Các mô tả trước đó từng xét cách tìm đệ quy những dòng duy nhất trong từng phần nhỏ, nhưng Cohen cho biết ông đã bỏ lượt đệ quy vì lượt này tốn công tính toán mà hiếm khi tìm thêm được các cặp khớp hữu ích. Năm 2017, James Coglan công bố một bài phân tích cách triển khai, cho thấy về bản chất, patience diff là cách chia văn bản dựa trên quy tắc kinh nghiệm, chứ không phải một thuật toán tự tạo ra kết quả diff hoàn chỉnh. Khi phần văn bản nằm giữa các điểm neo không có dòng nào chỉ xuất hiện một lần, thuật toán phải dùng một thuật toán thông thường như Myers làm phương án dự phòng để so sánh phần còn lại.
Git cung cấp tùy chọn --patience cùng với --histogram, một phần mở rộng chấp nhận cả những phần tử chung có số lần xuất hiện thấp, đồng thời vẫn giữ Myers làm thuật toán mặc định. Patience diff không hiểu cây cú pháp của ngôn ngữ lập trình và không bảo đảm tạo ra chuỗi thao tác chỉnh sửa ngắn nhất; Git cung cấp khả năng đó qua tùy chọn riêng --minimal.
Các thuật toán so sánh hoạt động tốt nhất khi tính đến việc không phải dòng nào cũng có giá trị ngang nhau. Bằng cách ưu tiên những dòng chung chỉ xuất hiện một lần làm mốc, patience diff có thể ghép các dòng rõ ràng hơn, ngay cả khi chuỗi thao tác chỉnh sửa thu được chưa phải ngắn nhất có thể.
Bài liên quan
Đọc bằng ngôn ngữ khác: English
Nguồn
- Patience Diff Advantages (Bram Cohen, ngày 30 tháng 3 năm 2010)
- Tài liệu Git: diff-options (git-scm.com)
- The patience diff algorithm (James Coglan, ngày 19 tháng 9 năm 2017)
- Implementing patience diff (James Coglan, ngày 28 tháng 9 năm 2017)
- Ảnh đại diện: Colin; Wikimedia Commons; CC BY-SA 4.0 (đã chỉnh sửa từ ảnh gốc)
