23/10/2026 · VietTechies · Biên tập
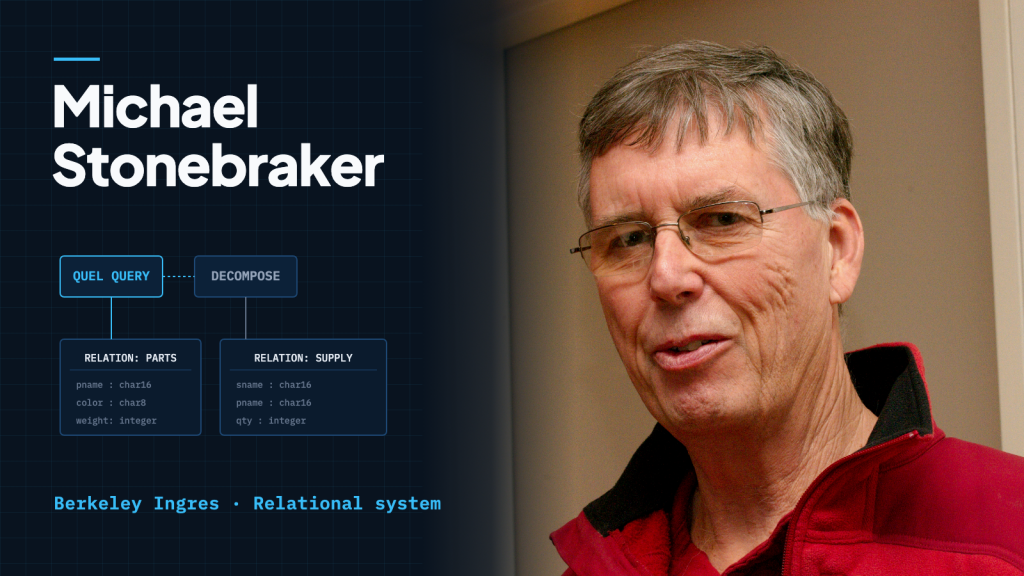
Năm 1974, dự án Ingres của Michael Stonebraker và Eugene Wong tại Đại học California, Berkeley đã trình diễn một hệ thống ban đầu hiện thực hóa các ý tưởng về cơ sở dữ liệu quan hệ của Edgar F. Codd. Theo công trình lịch sử do National Research Council công bố năm 1999, sau đó nhóm đã sửa đổi đáng kể để code dễ bảo trì.
Sau phiên bản đầu tiên, Stonebraker, Wong và các đồng nghiệp tiếp tục phát triển Ingres. Họ nhiều lần viết lại bản mẫu để đưa vào những kinh nghiệm tích lũy, phản hồi của người dùng và ý tưởng mới. Về sau, công nghệ Ingres được phổ biến nhờ mã nguồn công khai, các nhà nghiên cứu chuyển sang làm việc trong ngành và các công trình được công bố.
Cơ sở dữ liệu điều hướng trước thời Codd
Đầu thập niên 1970, muốn quản lý hồ sơ kinh doanh trên máy tính, lập trình viên phải tự chỉ dẫn từng bước tìm dữ liệu. Họ dựa vào các hệ quản trị theo mô hình phân cấp như Information Management System (IMS) của IBM, hoặc các cơ sở dữ liệu theo mô hình mạng do Conference on Data Systems Languages (Codasyl) chuẩn hóa. Để lấy bản ghi, lập trình viên chỉ định từng bước truy xuất trong cơ sở dữ liệu. Cách làm này có thể khiến chương trình ứng dụng phụ thuộc vào chi tiết tổ chức dữ liệu, làm cho việc thay đổi trở nên khó khăn hơn.
Năm 1970, nhà toán học Edgar F. Codd tại IBM Research công bố một bài báo mang tính bước ngoặt, đề xuất một hướng đi khác hẳn. Codd cho rằng dữ liệu nên được biểu diễn dưới dạng các quan hệ toán học — những bảng đơn giản gồm hàng và cột — độc lập với chi tiết lưu trữ vật lý. Thay vì viết code chỉ đường truy xuất trên đĩa, người dùng sẽ viết truy vấn khai báo, nêu dữ liệu mình muốn lấy và để hệ quản trị cơ sở dữ liệu lập kế hoạch truy xuất. Tuy nhiên, IBM đã đầu tư cả tiền bạc lẫn nguồn lực tổ chức vào IMS, khiến việc tiếp nhận một công nghệ cạnh tranh gặp sức cản.
Tìm nguồn tài trợ để xây dựng hệ thống thực tế
Khoảng năm 1973, Stonebraker và Wong bắt đầu say mê những đề xuất của Codd. Tại Berkeley, ban đầu họ tìm kinh phí để xây dựng một hệ thống truy xuất dữ liệu địa lý cho nhóm kinh tế học của trường. Nguồn gốc ấy được giữ lại trong tên dự án: Interactive Graphics and Retrieval System, viết tắt là Ingres. Khi Stonebraker tìm đến Cơ quan Các dự án Nghiên cứu Quốc phòng Tiên tiến (DARPA) và Văn phòng Nghiên cứu Hải quân (ONR) để xin tài trợ xây dựng một cơ sở dữ liệu quan hệ hoàn chỉnh, cả hai đều từ chối vì đã tài trợ cho những dự án cơ sở dữ liệu ở nơi khác.
Stonebraker không chịu từ bỏ ý tưởng. Với sự giúp đỡ của Wong và đồng nghiệp Lotfi Zadeh tại Berkeley, ông huy động được khoản kinh phí khiêm tốn từ Quỹ Khoa học Quốc gia (NSF) cùng ba cơ quan quân sự: Văn phòng Nghiên cứu Khoa học Không quân, Văn phòng Nghiên cứu Lục quân và Bộ Tư lệnh Các hệ thống Điện tử Hải quân. Nguồn tài trợ chắp vá từ nhiều cơ quan này giúp nhóm Berkeley theo đuổi một hệ thống quan hệ hoàn chỉnh.
Viết lại code để dễ bảo trì
Sau buổi trình diễn năm 1974, trọng tâm công việc chuyển từ chứng minh ý tưởng quan hệ sang làm cho code dễ bảo trì. Theo National Research Council, điều đó đồng nghĩa với nhiều lần sửa đổi đáng kể, chứ không phải chỉ một bản dựng hoàn chỉnh duy nhất.
Ingres là thành quả của cả một tập thể. Từ năm 1973 đến năm 1979, khoảng ba mươi người từng tham gia nhóm Ingres, nhưng ở bất kỳ thời điểm nào nhóm cũng chỉ có tối đa năm hoặc sáu lập trình viên. Bài báo thiết kế ban đầu ghi tên M. Stonebraker, G. Held, E. Wong và P. Kreps. Sổ tay tham khảo năm 1977 ghi tên K. Youssefi, N. Whyte, M. Ubell, D. Ries, P. Hawthorn, B. Epstein, R. Berman và E. Allman.
Nhóm phát triển các kỹ thuật phân rã truy vấn và tạo ra QUEL, một ngôn ngữ truy vấn khai báo: người dùng chỉ định dữ liệu họ muốn lấy thay vì các bước truy xuất. QUEL dựa trên phép tính quan hệ bộ, một cách mô tả bằng toán học những bản ghi cần lấy, và cạnh tranh với Structured English Query Language (SEQUEL) của IBM, về sau được gọi là Structured Query Language (SQL).
Phổ biến kiến trúc ra thế giới
Một yếu tố then chốt tạo nên ảnh hưởng của Ingres là quyết định phân phối mã nguồn miễn phí của Berkeley. Mã nguồn Ingres được công khai, và khoảng 1.000 bản sao đã được phân phối trên toàn thế giới để các nhà khoa học máy tính và lập trình viên có thể thử nghiệm, điều chỉnh hệ thống. Việc máy tính giá rẻ của Digital Equipment Corporation (DEC) ngày càng phổ biến trong các trường đại học đã giúp Ingres lan rộng. Nghiên cứu System R của IBM cũng có ảnh hưởng đến lĩnh vực này thông qua các công trình công bố và công việc của các nhà nghiên cứu tham gia dự án.
Năm 1980, Stonebraker, Wong và Lawrence Rowe thành lập Relational Technology, Inc., sau đổi tên thành INGRES Corporation, để thương mại hóa mã nguồn Berkeley. Các thành viên nhóm Ingres về sau thành lập hoặc lãnh đạo những công ty cơ sở dữ liệu lớn, trong đó có Sybase, Britton-Lee và Illustra. Dưới sự dẫn dắt của Stonebraker tại Berkeley, công việc xây dựng POSTGRES bắt đầu vào năm 1986, mở rộng các hệ thống quan hệ để hỗ trợ dữ liệu phức tạp hơn. Năm 1994, Andrew Yu và Jolly Chen bổ sung trình thông dịch SQL vào POSTGRES. Sau đó, hệ thống được phát hành trên web với tên Postgres95, và dự án lấy tên PostgreSQL vào năm 1996.
Vì sao những lần sửa đổi Ingres có ý nghĩa
Lịch sử Ingres cho thấy những lần sửa đổi liên tục giúp một hệ thống thử nghiệm phát triển vượt ra ngoài giai đoạn trình diễn ban đầu. Làm cho code dễ bảo trì là trọng tâm của công việc ấy, bên cạnh chia sẻ mã nguồn, công bố kết quả và đưa kinh nghiệm vào các hệ thống thương mại.
Một truy vấn chạy được là phép thử cho ý tưởng; bảo trì và điều chỉnh code qua nhiều năm là phép thử cho thiết kế kỹ thuật.
Bài liên quan
Đọc bằng ngôn ngữ khác: English
Nguồn
- National Research Council (1999), Funding a Revolution: Government Support for Computing Research, Chương 6: The Rise of Relational Databases, tr. 162–166.
- Adam Conner-Simons (2015), Michael Stonebraker wins $1 million Turing Award, MIT News, ngày 25 tháng 3 năm 2015.
- Đại học California, Berkeley, Khoa Kỹ thuật Điện và Khoa học Máy tính, Eugene Wong Faculty Home Page.
- K. Youssefi, N. Whyte, M. Ubell, D. Ries, P. Hawthorn, B. Epstein, R. Berman và E. Allman (1977), Ingres Reference Manual- Version 6.1, Phòng thí nghiệm Nghiên cứu Điện tử UC Berkeley, Bản ghi nhớ số UCB/ERL M579.
- PostgreSQL Global Development Group (2026), A Brief History of PostgreSQL, Tài liệu PostgreSQL 18, Chương 2.
- Ảnh đại diện: Dcoetzee; Wikimedia Commons; CC0 (đã chỉnh sửa từ ảnh gốc)
