
08/10/2026 · VietTechies · Biên tập

Vào năm 2020, Viện Dịch vụ Bảo tàng và Thư viện đã trao khoản tài trợ mã số MC-245791-OMS-20 cho Bảo tàng Lịch sử Máy tính (Computer History Museum). Khoản tài trợ liên bang trị giá 50.000 USD này—cùng với 15.000 USD quy đổi từ thời gian làm việc của nhân viên bảo tàng và 20.000 USD từ Quỹ Gordon and Betty Moore—đã tài trợ cho một thử nghiệm kéo dài một năm nhằm kiểm tra liệu trí tuệ nhân tạo thương mại có thể tự động lập chỉ mục và ghi chép lại bộ sưu tập tài liệu lịch sử truyền miệng đồ sộ của bảo tàng hay không.
Thử nghiệm lưu trữ trên nền tảng đám mây Azure
Để giúp công chúng trên toàn cầu tiếp cận bộ lưu trữ đồ sộ của mình theo một sáng kiến mang tên OpenCHM, bảo tàng đã thu thập một tập dữ liệu thử nghiệm tập trung vào lịch sử của Xerox PARC và trí tuệ nhân tạo. Thay vì xây dựng các mô hình tùy chỉnh, đội ngũ dự án đã đưa các video, tệp âm thanh và tài liệu quét lịch sử vào Microsoft Azure, sử dụng các dịch vụ sẵn có là Cognitive Services và Video Indexer. Quy trình xử lý trên đám mây đã phân tích từng khung hình video thô để nhận diện khuôn mặt, xử lý các bản ghi âm để phân tích cảm xúc và phân tích văn bản tài liệu nhằm tạo ra dữ liệu tả (metadata) có thể tìm kiếm trên hàng nghìn phút phim lịch sử.
Dịch thuật tư liệu của các nhà tiên phong và những thiếu sót kỹ thuật
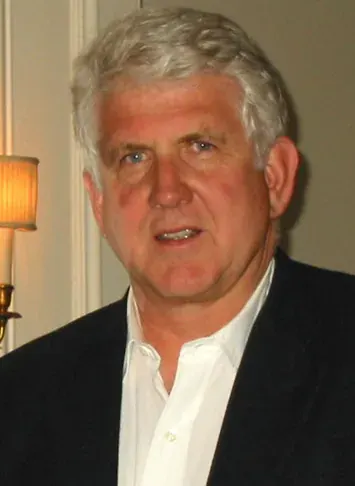
Hệ thống tự động nhanh chóng thể hiện khả năng đa ngôn ngữ. Quy trình đã phân tích bản ghi video của Bob Metcalfe, đồng sáng chế mạng Ethernet, để tạo ra bản ghi chép văn bản có gắn nhãn thời gian và tự động dịch sang tiếng Trung; trong khi bản ghi chép của Alvy Ray Smith, nhà tiên phong về đồ họa máy tính, được dịch sang tiếng Hindi. Dù vậy, những thiếu sót về mặt kỹ thuật đã cản trở quá trình thực thi dự án. Do yêu cầu nhập dữ liệu tả hiện có do con người biên tập bị bỏ qua trong giai đoạn đầu thiết lập cơ sở dữ liệu, việc gắn lại thông tin cũ đó về sau trở nên vô cùng tốn kém. Những hạn chế về ngân sách và tiến độ cũng buộc đội ngũ phải loại bỏ một tính năng khám phá quan trọng: công cụ trực quan hóa đồ thị mạng tương tác được thiết kế để kết nối các kết quả tìm kiếm.
Khoảng cách giữa nhân viên nội bộ và các học giả bên ngoài
Khảo sát sau khi triển khai cho thấy sự khác biệt rõ rệt giữa nhân viên nội bộ và các nhà nghiên cứu bên ngoài. Chưa đến một nửa số nhân viên bảo tàng đánh giá các từ khóa chủ đề do máy tạo ra là hữu ích, đồng thời chỉ trích khả năng của máy trong việc suy luận ngữ cảnh ngoài các từ ngữ chính xác trong văn bản. Trái lại, các nhà nghiên cứu học thuật bên ngoài lại dành sự khen ngợi lớn cho dữ liệu tả tự động, coi các từ khóa do máy tạo ra là một bước tiến vượt bậc so với các kho lưu trữ chưa được lập chỉ mục. Các mô hình thương mại sẵn có cũng cho thấy khả năng liên tưởng đáng chú ý đối với các nhân vật nổi tiếng, khi kết nối chính xác Steve Jobs và Gordon Bell với Huân chương Quốc gia về Công nghệ và Đổi mới sáng tạo (National Medal of Technology and Innovation), cũng như Nandan Nilekani với chức danh Chủ tịch của Infosys.
Bảo tàng Lịch sử Máy tính đã xác định rằng việc tự động ghi chép văn bản sẽ là ưu tiên hàng đầu để phục vụ việc truy cập toàn cầu, với điều kiện các mô hình trong tương lai phải được huấn luyện tùy chỉnh trên các bản ghi chép gốc của bảo tàng và được dán nhãn rõ ràng bên cạnh dữ liệu do con người biên tập.
Ảnh đầu bài: minh họa do AI tạo, không phải ảnh tư liệu.