21/10/2026 · VietTechies · Biên tập
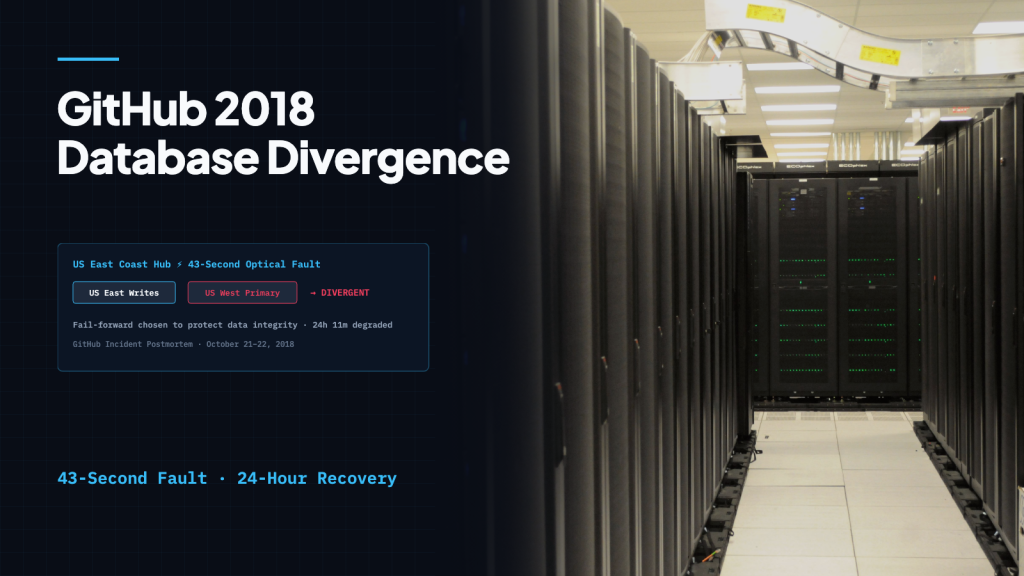
Ngày 21/10/2018, GitHub mất kết nối mạng trong 43 giây. Chất lượng dịch vụ của GitHub suy giảm suốt 24 giờ 11 phút: kết nối đã trở lại, nhưng các cơ sở dữ liệu ở hai bờ nước Mỹ lúc này lại lưu những lịch sử khác nhau về các lệnh ghi đã tiếp nhận.
Nối lại đường truyền không thể giải quyết câu hỏi những bản ghi nào cần có trong hệ thống sau khôi phục. Các kỹ sư GitHub phải thiết lập lại hệ thống cơ sở dữ liệu để có thể sử dụng, đồng thời giữ lại những thay đổi đã nhận từ người dùng.
Điều khó xử là hệ thống tự động chuyển sang máy dự phòng khi có sự cố đã hoạt động đúng cấu hình. Hệ thống đã chuyển vai trò cơ sở dữ liệu chính tới một nơi mà ứng dụng khó sử dụng hiệu quả.
Có cơ sở dữ liệu thay thế mới chỉ giải quyết được một phần
GitHub không chỉ lưu các kho Git. Các cơ sở dữ liệu MySQL còn phục vụ việc quản lý vấn đề (issue), yêu cầu hợp nhất code (pull request), xác thực và tác vụ nền. Nếu không thể truy cập ổn định vào những siêu dữ liệu này, website vẫn có thể gián đoạn dù vấn đề không nằm ở phần lưu trữ đối tượng Git thô.
Mỗi cụm cơ sở dữ liệu có một server chính nhận các lệnh ghi và những bản sao (replica) nhận lại các thay đổi, đồng thời xử lý một phần đáng kể lưu lượng đọc. Orchestrator, công cụ quản lý cách bố trí này, có thể đưa một server khác lên làm server chính khi cách bố trí hiện tại gặp sự cố.
Trong một bài viết năm 2016, kỹ sư GitHub Shlomi Noach đã giải thích nhu cầu vận hành đó: chờ ai đó thức dậy rồi sửa server chính bị hỏng sẽ mất quá nhiều thời gian. Hệ thống tự động còn phải phân biệt giữa một server thực sự hỏng và trường hợp chỉ có nút giám sát không kết nối được tới server ấy.
Sự phân biệt đó trở nên quan trọng trong đợt bảo trì định kỳ ngày 21/10. Lúc 22:52 theo Giờ Phối hợp Quốc tế (UTC), công việc thay thế thiết bị quang đang trục trặc đã làm gián đoạn kết nối giữa đầu mối mạng của GitHub ở Bờ Đông và trung tâm dữ liệu chính của họ tại Bờ Đông.
Trong lúc mất kết nối, các nút Orchestrator ở Bờ Tây và trên một đám mây công cộng tại Bờ Đông vẫn có thể đạt được sự đồng thuận cần thiết để hành động. Chúng bắt đầu đưa các cơ sở dữ liệu ở Bờ Tây lên làm cơ sở dữ liệu chính. Khi kết nối trở lại, ứng dụng bắt đầu gửi lệnh ghi tới các cơ sở dữ liệu chính mới này.
Hai bên đã nhận những thay đổi khác nhau
Các cơ sở dữ liệu ở Bờ Đông chứa những lệnh ghi trong một khoảng thời gian ngắn chưa kịp chuyển sang Bờ Tây. Sau đó, các cơ sở dữ liệu vừa được đưa lên làm cơ sở dữ liệu chính ở Bờ Tây lại nhận thêm lệnh ghi. Mỗi bên đều giữ những thay đổi mà bên kia không có.
Vì thế, nếu chỉ chuyển trở lại Bờ Đông, một phần thay đổi đã nhận sẽ nằm ngoài lịch sử dữ liệu mà hệ thống đang sử dụng. Báo cáo sự cố mô tả việc các kỹ sư chọn tiếp tục khôi phục từ trạng thái dữ liệu ở Bờ Tây, đồng thời giữ lại những bản ghi còn tồn ở Bờ Đông để đối soát.
Quyết định đó lập tức kéo theo một cái giá. Các ứng dụng chạy ở Bờ Đông không chịu được độ trễ tăng thêm khi liên tục truy cập cơ sở dữ liệu chính ở phía bên kia nước Mỹ. Cơ sở dữ liệu có thể vẫn hoạt động, nhưng lại ở quá xa so với yêu cầu của ứng dụng.
Lúc 23:19 UTC, các kỹ sư tạm dừng gửi webhook — những thông báo gửi tới các dịch vụ được kết nối — và tạm dừng các lượt dựng GitHub Pages. Họ nêu rõ rằng tính toàn vẹn của dữ liệu được ưu tiên hơn khả năng sử dụng website và thời gian khôi phục. Nếu tiếp tục chạy tác vụ nền, hệ thống sẽ phát sinh thêm lệnh ghi trong lúc họ đang cố ổn định các cơ sở dữ liệu.
Bản sao lưu vẫn cần thời gian mới có thể phục vụ ứng dụng
Kế hoạch khôi phục gồm phục hồi từ bản sao lưu, đồng bộ các bản sao ở cả hai địa điểm, đưa hệ thống về cách bố trí ổn định rồi xử lý các tác vụ đang chờ.
Có bản sao lưu không có nghĩa là có thể hoàn thành ngay chuỗi công việc ấy. Để khôi phục nhiều terabyte, nhóm phải chuyển dữ liệu từ nơi lưu trữ từ xa, giải nén, kiểm tra, chuẩn bị rồi nạp vào các server MySQL mới được cấp phát. GitHub cho biết quy trình khôi phục được kiểm thử hằng ngày, nhưng trước đó công ty chưa từng phải dựng lại cả một cụm từ bản sao lưu ngay trong một sự cố.
Đến 11:12 UTC ngày 22/10/2018, các cơ sở dữ liệu chính đã trở lại Bờ Đông. Thao tác ghi phản hồi nhanh hơn vì ứng dụng và các cơ sở dữ liệu chính lại ở gần nhau. Tuy nhiên, một số bản sao phục vụ đọc vẫn chậm hơn hàng giờ. Những yêu cầu được chuyển tới các bản sao đó vẫn có thể nhận về thông tin cũ.
Ước tính thời gian khôi phục trước đó của nhóm dựa trên giả định rằng quá trình sao chép sẽ bắt kịp dữ liệu theo tiến độ tuyến tính. Thực tế không như vậy. Lưu lượng tăng vào ban ngày làm hệ thống chịu thêm tải, và độ trễ sao chép ngày càng lớn. Việc bổ sung các bản sao phục vụ đọc giúp chia tải để quá trình đồng bộ có thể tiếp tục tiến triển.
Các tác vụ tồn đọng lại gặp một kiểu lỗi riêng
Lúc 16:24 UTC, các bản sao đã đồng bộ, cho phép hệ thống trở về cấu trúc ban đầu. GitHub vẫn giữ trạng thái dịch vụ ở mức đỏ trong lúc các kỹ sư xử lý những tác vụ dồn lại.
Hơn năm triệu sự kiện hook và 80.000 lượt dựng Pages đang nằm trong hàng đợi. Khi cho xử lý trở lại, nhóm phải cân bằng tốc độ khôi phục với tải đặt lên GitHub và các dịch vụ bên ngoài nhận thông báo.
Khoảng 200.000 gói dữ liệu gửi kèm (payload) của webhook đã quá thời hạn lưu nội bộ và bị loại bỏ trong quá trình xử lý. Các kỹ sư tạm dừng công việc này và tạm thời kéo dài thời hạn. Hàng đợi có thể giữ tác vụ suốt thời gian dịch vụ gián đoạn, nhưng vẫn loại bỏ tác vụ khi việc khôi phục tiến đến bước xử lý tác vụ đó.
Website trở lại trạng thái xanh lúc 23:03 UTC. Tuy vậy, báo cáo phân tích sự cố (postmortem) cho biết việc đối soát những lệnh ghi còn tồn ở Bờ Đông vẫn đang tiếp diễn khi báo cáo được công bố. Cần đọc chi tiết này cùng với tuyên bố của công ty rằng không có dữ liệu người dùng nào bị mất; báo cáo cũng ghi rõ các gói dữ liệu webhook đã bị loại bỏ.
Chuyển sang máy dự phòng phải phù hợp với ứng dụng
GitHub xác định một thay đổi cấu hình cụ thể: ngăn Orchestrator đưa cơ sở dữ liệu ở vùng khác lên làm cơ sở dữ liệu chính. Công cụ đã hành động đúng cấu hình, nhưng việc truy cập cơ sở dữ liệu xuyên nước Mỹ sau đó vượt quá khả năng đáp ứng của ứng dụng.
Công ty cũng cam kết kiểm thử các kịch bản sự cố có hệ thống hơn. Câu hỏi cần đặt ra không chỉ là có chọn được cơ sở dữ liệu chính thay thế hay không: ứng dụng có dùng được cơ sở dữ liệu ấy không, các bản sao có bắt kịp dữ liệu khi vẫn có lưu lượng truy cập không, và các tác vụ trong hàng đợi có được giữ lại cho tới lúc xử lý trở lại không?
Kết nối mạng gián đoạn trong 43 giây. Để khôi phục, nhóm phải đưa các cơ sở dữ liệu, ứng dụng và những tác vụ đang chờ về trạng thái nhất quán với nhau.
Bài liên quan
Đọc bằng ngôn ngữ khác: English
Nguồn
- Jason Warner — October 21 post-incident analysis
- Shlomi Noach — Orchestrator at GitHub
- Shlomi Noach — MySQL High Availability at GitHub
- Chris Williams, The Register — GitHub.com freezes up as techies race to fix dead data storage gear
- Ảnh đại diện: Derrick Coetzee from Berkeley, CA, USA; Wikimedia Commons; CC0 (đã chỉnh sửa từ ảnh gốc)
