26/10/2026 · VietTechies · Biên tập
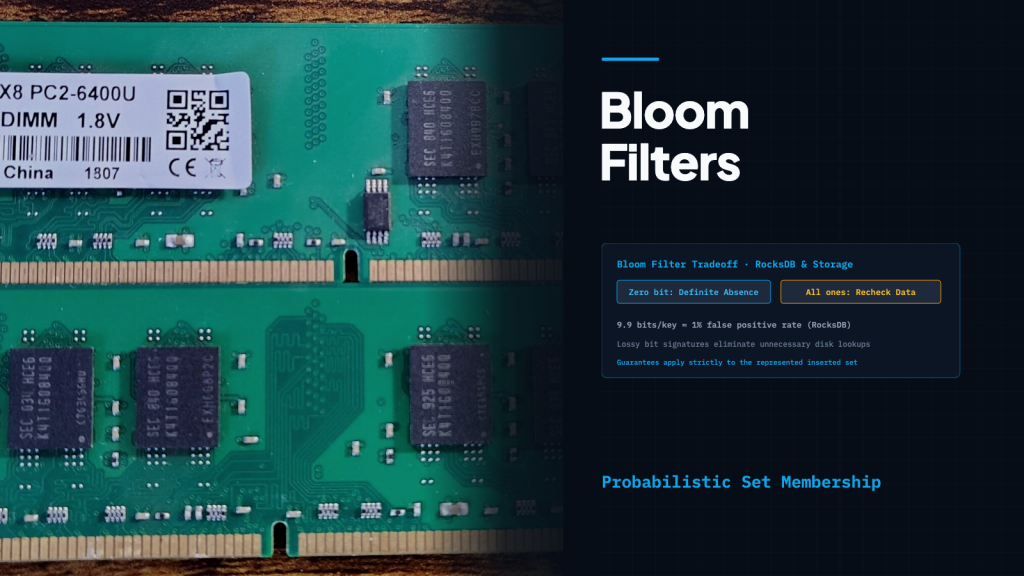
Theo hướng dẫn về Bloom filter của RocksDB, tỷ lệ dương tính giả 1% cần khoảng 9,9 bit cho mỗi khóa. Bộ lọc nhỏ gọn này giúp bộ máy lưu trữ bỏ qua những lần tìm kiếm khi nhận được câu trả lời phủ định; còn khi câu trả lời là khẳng định, hệ thống vẫn phải kiểm tra dữ liệu đã lưu.
Bộ lọc tiết kiệm dung lượng bằng cách chấp nhận một số kết quả dương tính giả, nhưng vẫn bảo đảm câu trả lời phủ định là chắc chắn đối với tập khóa đã đưa vào bộ lọc. Bộ lọc nhỏ gọn loại trừ các khả năng, còn dữ liệu bên dưới mới cho câu trả lời chính xác.
Một bước kiểm tra nhỏ trước khi tìm trong dữ liệu
Tài liệu về Bloom filter của RocksDB mô tả các bộ lọc được nhúng trong những tệp bảng chuỗi đã sắp xếp, gọi tắt là SST, mới tạo khi hệ thống được cấu hình sử dụng bộ lọc. Mỗi bộ lọc đại diện cho một tập khóa gắn với dữ liệu đã lưu. Trước khi tìm kiếm trong dữ liệu đó, RocksDB có thể kiểm tra xem khóa cần tìm có khả năng hiện diện hay không.
Câu trả lời phủ định loại tập khóa mà bộ lọc đại diện khỏi phạm vi tìm kiếm. Câu trả lời khẳng định giữ tập khóa đó lại để kiểm tra tiếp. Bộ lọc không trả về giá trị gắn với khóa, và kết quả khẳng định cũng không chứng minh khóa thuộc tập đó.
Phạm vi ở đây rất quan trọng. Bộ lọc gắn với một tệp chỉ trả lời về các khóa mà nó đại diện trong tệp đó. Chỉ riêng bộ lọc này không thể xác định một khóa có tồn tại ở đâu đó trong toàn bộ cơ sở dữ liệu hay không.
Thiết kế của các bộ lọc này cũng đã thay đổi để giảm chi phí bộ nhớ. Tài liệu RocksDB ghi nhận một định dạng cũ tạo các Bloom filter riêng cho từng vùng lưu trữ khóa/giá trị có kích thước 2 KB; hệ thống vẫn phải tải chỉ mục của tệp trước khi kiểm tra bộ lọc. Thiết kế bộ lọc toàn tệp ra đời sau đó tạo một bộ lọc cho cả tệp SST. Thiết kế này giới hạn các lần dò tìm một khóa trong một dòng bộ nhớ đệm (cache line) của bộ xử lý trung tâm (CPU), nhằm giảm cache miss mà vẫn giữ nguyên bảo đảm về câu trả lời phủ định.
Vì sao dùng chung bit chỉ gây sai theo một phía
Cơ chế bắt đầu với một mảng bit. Khi thêm một khóa, bộ lọc dùng các hàm băm để ánh xạ khóa đó tới những vị trí trong mảng, rồi đặt các bit ở đó thành 1. Khi kiểm tra một khóa, bộ lọc xem các vị trí được tính theo cùng cách.
Nếu bất kỳ vị trí nào được kiểm tra chứa bit 0, khóa đó chưa được thêm vào: nếu đã thêm, bit tại vị trí ấy phải là 1. Tuy nhiên, nếu tất cả các vị trí được kiểm tra đều chứa bit 1, câu trả lời vẫn chưa chắc chắn. Những khóa khác có thể đã đặt các bit ở cùng những vị trí đó.
Để minh họa, giả sử một khóa được ánh xạ tới một số vị trí mà những lần thêm khóa khác đã đặt thành 1. Khi kiểm tra, bộ lọc chỉ thấy các bit 1 dù khóa đó chưa từng được thêm vào. Đây là kết quả dương tính giả. Bộ lọc lưu một mẫu bit nhỏ gọn mà nhiều khóa dùng chung, thay vì một danh sách khóa chính xác.
Guava, thư viện tiện ích Java của Google, nêu rõ bảo đảm khi thêm phần tử: sau khi một phần tử được đưa vào Bloom filter, những lần kiểm tra sau đó xem phần tử ấy có thuộc tập hay không sẽ trả về true. Phương thức kiểm tra có tên mightContain, thể hiện rõ rằng câu trả lời khẳng định vẫn chưa chắc chắn.
Muốn có kết quả chính xác, phải kiểm tra dữ liệu
Phần mở rộng chỉ mục bloom của PostgreSQL 18 áp dụng cùng nguyên tắc chung thông qua các chữ ký nhỏ gọn của những thuộc tính được lập chỉ mục. Các chữ ký này có thể loại trừ những hàng không khớp, nhưng không giữ lại đầy đủ thông tin: một hàng có thể vượt qua bước kiểm tra chữ ký dù không khớp với truy vấn thực tế.
Vì vậy, tài liệu PostgreSQL yêu cầu kiểm tra lại kết quả từ chỉ mục bằng các giá trị thuộc tính thực sự được lưu. Kết quả dương tính giả làm phát sinh thêm công việc kiểm tra, nhưng bước kiểm tra lại giúp nó không trở thành kết quả truy vấn sai.
Phần mở rộng này hỗ trợ tìm kiếm theo điều kiện bằng, thay vì tìm kiếm theo khoảng. Theo tài liệu, các bảng có nhiều thuộc tính, được truy vấn theo nhiều tổ hợp khác nhau, là một trường hợp phù hợp để sử dụng. Đây là những đặc tính và trường hợp sử dụng của cách triển khai trong PostgreSQL, chứ không phải những bảo đảm áp dụng cho mọi Bloom filter.
Tỷ lệ dương tính giả 1% nghĩa là gì?
Mẫu số ở đây rất dễ bị hiểu nhầm. Guava định nghĩa xác suất dương tính giả là xác suất trả về true cho một phần tử chưa được thêm vào bộ lọc. Tương tự, tài liệu RocksDB tính tỷ lệ quan sát được trên các truy vấn tìm khóa hoặc tiền tố không có trong tệp mà bộ lọc đại diện.
Vì vậy, tỷ lệ 1% nói về các truy vấn tìm phần tử vắng mặt. Tỷ lệ này không có nghĩa là 1% tổng số câu trả lời khẳng định là sai. Tỷ trọng câu trả lời khẳng định sai còn phụ thuộc vào tần suất các phần tử được hỏi thực sự hiện diện.
Sự khác biệt này ảnh hưởng đến cách đánh giá ích lợi của bộ lọc. Nếu hệ thống thường xuyên nhận truy vấn tìm các khóa vắng mặt, bộ lọc sẽ có cơ hội loại bỏ những lần tìm kiếm. Để đánh giá mức tiết kiệm, cần cân nhắc lượng công việc tránh được so với bộ nhớ và thời gian xử lý mà chính bộ lọc tiêu tốn.
Độ chính xác cần tài nguyên
Hướng dẫn cấu hình RocksDB đưa ra mức khoảng 9,9 bit cho mỗi khóa để đạt tỷ lệ dương tính giả 1%, và 15,5 bit cho mỗi khóa để đạt tỷ lệ 0,1%. Đây là các con số dung lượng dành riêng cho cách triển khai này, không phải số đo chung cho mọi thiết kế Bloom filter.
Dùng thêm dung lượng có thể giảm những lần tìm kiếm không cần thiết, nhưng bản thân bộ lọc cũng tốn thời gian xử lý. PostgreSQL mô tả một sự đánh đổi tương tự: chữ ký lớn hơn giúp giảm kết quả dương tính giả và những lần truy cập không cần thiết tới các hàng đã lưu, nhưng khiến chỉ mục lớn hơn và mất nhiều thời gian quét hơn.
Việc dự tính sức chứa cũng quan trọng. Guava cảnh báo rằng thêm nhiều phần tử vượt xa số lượng dự kiến có thể làm bộ lọc có kích thước cố định bị bão hòa, khiến xác suất dương tính giả tăng mạnh. Càng thêm nhiều khóa, càng nhiều bit sẵn có được đặt thành 1, nên kết quả toàn bit 1 càng kém chọn lọc.
Redis đưa ra một lựa chọn triển khai khác. Lệnh BF.RESERVE tạo một bộ lọc mà theo mặc định sẽ bổ sung các bộ lọc con khi đạt sức chứa. Việc duy trì và truy vấn các bộ lọc con này tốn thêm bộ nhớ và thời gian xử lý. Khi chọn NONSCALING, theo tài liệu của lệnh, bộ lọc trả về lỗi khi đạt sức chứa.
Phạm vi bảo đảm phụ thuộc vào tập khóa mà bộ lọc đại diện
Bảo đảm khi thêm phần tử cũng đặt ra một giới hạn cho thiết kế ứng dụng. Nếu một bộ lọc riêng được dùng để đại diện cho các bản ghi trong cơ sở dữ liệu, những bản ghi đó phải thực sự được thêm vào bộ lọc bằng một cách biểu diễn nhất quán. Với bản ghi bị bỏ sót, câu trả lời phủ định của bộ lọc không thể xác định bản ghi đó có tồn tại hay không.
Đó là hệ quả kỹ thuật của bảo đảm này: một bộ lọc thiếu dữ liệu hoặc cập nhật chậm không thể chứng minh rằng một bản ghi hiện không có trong cơ sở dữ liệu. Ứng dụng phải duy trì sự tương ứng giữa bộ lọc và nguồn dữ liệu chuẩn của mình.
Trong phạm vi tập mà bộ lọc đại diện, vai trò của từng kết quả vẫn rõ ràng. Một bit 0 loại trừ khóa đang xét. Kết quả toàn bit 1 đưa quá trình tìm kiếm tiếp tục đến dữ liệu thực.
Bài liên quan
Đọc bằng ngôn ngữ khác: English
Nguồn
- RocksDB Bloom Filter — cơ chế, phạm vi trong tệp và những đánh đổi khi cấu hình
- Guava 33.4.8-jre BloomFilter API — bảo đảm về phần tử thuộc tập, xác suất dương tính giả và sự bão hòa
- PostgreSQL 18 bloom index documentation — chữ ký, kiểm tra lại và các giới hạn
- Redis BF.RESERVE reference — sức chứa, khả năng mở rộng và chi phí tài nguyên
- Ảnh đại diện: SaltyCruton; Wikimedia Commons; CC0 1.0 (đã chỉnh sửa từ ảnh gốc)
