25/10/2026 · VietTechies · Biên tập
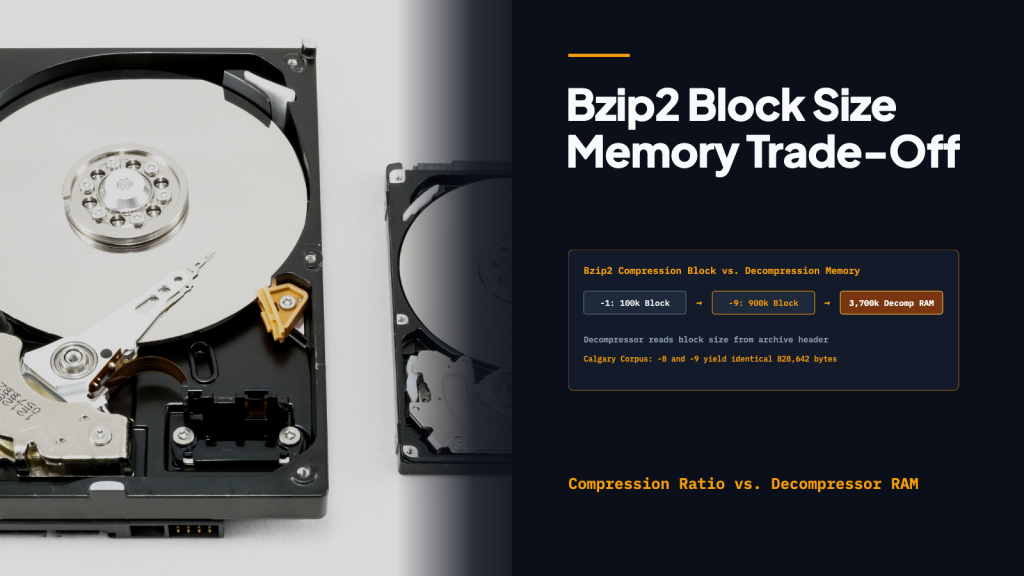
Khi nén một tệp bằng bzip2 với thiết lập mặc định, bạn âm thầm quyết định một điều thay cho người nhận. Với kích thước khối mặc định 900 kilobyte, công cụ nén ghi một dấu hiệu vào phần đầu tệp. Sau đó, khi người nhận chạy bunzip2 để giải nén dữ liệu, máy tính của họ sẽ cấp phát khoảng 3.700 kilobyte bộ nhớ RAM. Người nhận không thể yêu cầu dùng khối nhỏ hơn lúc giải nén: bzip2 đọc kích thước khối trực tiếp từ tệp nén. Một tùy chọn riêng dành cho máy ít bộ nhớ có thể giảm lượng RAM cần dùng, nhưng phải đánh đổi bằng tốc độ.
Trong tài liệu chính thức của bzip2, tác giả Julian Seward nhấn mạnh sự đánh đổi không cân xứng này. Các tùy chọn nén từ -1 đến -9 đặt kích thước khối từ 100.000 byte đến 900.000 byte. Khối lớn hơn cho phép giải thuật phân tích một phần văn bản lớn hơn, nhờ đó tạo ra tệp nén nhỏ hơn. Nhưng vì từng khối phải được khôi phục trong bộ nhớ, người tạo tệp thực chất đã ấn định lượng bộ nhớ cơ bản cần có để giải nén.
Hoán vị trước khi dùng cây Huffman
Các công cụ nén tệp truyền thống dùng giải thuật Lempel–Ziv LZ77 hoặc LZ78 dựa vào từ điển để tìm các chuỗi byte lặp lại. Ngược lại, bzip2 đi theo một hướng hoàn toàn khác, dựa trên biến đổi Burrows–Wheeler. Thay vì trực tiếp thu nhỏ dữ liệu, giải thuật xử lý cả một khối văn bản cùng lúc, hoán vị các ký tự để những ký hiệu giống nhau nằm thành cụm mà vẫn giữ đủ thông tin để đảo ngược phép biến đổi.
Bản thân phép biến đổi không loại bỏ dù chỉ một byte. Sức mạnh của nó nằm ở chỗ chuẩn bị dữ liệu cho các bước tiếp theo. Khi những ký tự tương tự đã nằm cạnh nhau trong khối, các bước trung gian như mã hóa move-to-front (đưa ký hiệu vừa gặp lên đầu danh sách) và rút gọn các chuỗi lặp liên tiếp biến những mẫu lặp thành các dãy chủ yếu gồm số nguyên nhỏ và số không. Chỉ đến lúc đó, bộ mã hóa Huffman mới gán chuỗi bit ngắn cho các ký hiệu xuất hiện thường xuyên, đạt tỷ lệ nén văn bản mà các phương pháp từ điển thông thường từng khó sánh kịp.
Tốn thêm bộ nhớ, lợi ích tăng thêm giảm dần
Dù khối lớn hơn tạo ra tệp nén nhỏ hơn, lợi ích tăng thêm nhanh chóng giảm đi. Seward lưu ý trong tài liệu phần mềm rằng phần lớn lợi ích nén đã có được khi kích thước khối mới ở mức hai hoặc ba trăm kilobyte. Tăng từ -3 lên -9 đòi hỏi nhiều bộ nhớ làm việc hơn đáng kể, trong khi phần dung lượng tệp tiết kiệm thêm ngày càng ít.
Tài liệu minh họa mức chững lại này bằng 14 tệp của bộ dữ liệu Calgary Text Compression Corpus, tổng cộng 3.141.622 byte. Nén bộ dữ liệu với -1 cho kết quả 914.704 byte, đồng thời cần lượng bộ nhớ ước tính là 1.200 kilobyte để nén và 500 kilobyte để giải nén. Chuyển sang -3 giảm dung lượng tệp nén xuống còn 860.338 byte. Nhưng tăng đến -8 và -9 lại cho cùng kết quả 828.642 byte, dù lượng bộ nhớ giải nén ước tính tăng từ 3.300 kilobyte lên 3.700 kilobyte.
Với những hệ thống bị hạn chế nghiêm ngặt về phần cứng, Seward bổ sung một lối thoát: cờ cấu hình (flag) -s dành cho máy ít bộ nhớ. Khi giải nén, -s chuyển sang một giải thuật khác, giảm lượng bộ nhớ xuống còn khoảng 2,5 byte cho mỗi byte của khối. Nhờ đó, một khối 900 kilobyte chỉ còn cần 2.350 kilobyte bộ nhớ. Cái giá của mức giảm này là tốc độ: giải nén với cờ cấu hình tiết kiệm bộ nhớ chỉ chạy ở tốc độ khoảng một nửa bình thường.
Khối độc lập và tệp nén bị hỏng
Chia tệp nén thành các khối riêng biệt không chỉ tốn bộ nhớ mà còn mang lại một cơ chế bảo vệ. Trong một luồng dữ liệu liên tục duy nhất, chỉ một bit lỗi hoặc một lần gián đoạn đường truyền có thể làm hỏng toàn bộ dữ liệu phía sau. Trong bzip2, mỗi khối nén được phân định bằng một mẫu bit dài 48 bit và được bảo vệ bằng mã kiểm tra dư thừa vòng (CRC) 32 bit riêng.
Nhờ các khối tách biệt, tiện ích đi kèm bzip2recover có thể hoạt động. Khi một tệp nén nhiều khối bị hỏng do ổ đĩa hoặc đường truyền mạng, tiện ích này tìm ranh giới khối rồi trích xuất những phần có thể là khối dữ liệu thành các tệp riêng. Sau đó có thể kiểm tra các tệp này bằng bzip2 -t, để giải nén những khối còn nguyên vẹn và tách riêng các khối bị hỏng. Chọn khối nhỏ hơn khi nén làm giảm lượng dữ liệu có nguy cơ mất trong mỗi đoạn bị hỏng, nên quyết định về kích thước khối còn liên quan đến khả năng khoanh vùng lỗi.
Các bản sửa lỗi sau này và người bảo trì mới
Các bản cập nhật sau đó xử lý những trường hợp đặc biệt ở bước sắp xếp. Trong phiên bản 0.9.5a, Seward bổ sung một thủ tục sắp xếp dự phòng để hạn chế tình trạng chậm ở trường hợp xấu nhất với dữ liệu đầu vào lặp lại nhiều, chẳng hạn những cụm từ giống hệt nhau lặp thành chuỗi dài. Sau hơn hai thập niên được triển khai rộng rãi trên các bản phân phối Unix, việc bảo trì bzip2 được chuyển giao cho Federico Mena Quintero, một lập trình viên thuộc dự án môi trường màn hình nền GNOME, vào tháng 6 năm 2019. Tiếp đó là các bản phát hành nhỏ xử lý những bản vá tích lũy từ các bản phân phối, đồng thời giữ tính tương thích của tệp nén.
Với bzip2, chọn kích thước khối lớn hơn có thể cải thiện tỷ lệ nén nhưng cũng làm tăng lượng bộ nhớ mà chương trình giải nén cấp phát; lợi ích cụ thể phụ thuộc vào dữ liệu. Kết quả trên bộ dữ liệu Calgary cho thấy giới hạn đó: chuyển từ -8 sang -9 không làm thay đổi tổng dung lượng sau nén, vẫn là 828.642 byte, dù lượng bộ nhớ giải nén ước tính tăng từ 3.300 lên 3.700 kilobyte.
Với kỹ sư hệ thống, tiện ích này cho thấy lựa chọn của bên gửi trực tiếp đặt ra những ràng buộc cho bên nhận như thế nào. Người tạo tệp chọn kích thước khối để giảm dung lượng lưu trữ hoặc băng thông, nhưng phần cứng của người nhận mới quyết định liệu việc giải nén tệp đó có khả thi hay không.
Bài liên quan
Đọc bằng ngôn ngữ khác: English
Nguồn
- bzip2 and libbzip2 Manual (Phiên bản 1.0.8, Julian Seward)
- bzip2 CHANGES (Nhật ký thay đổi của dự án)
- Maintaining bzip2 (Federico Mena Quintero, ngày 4 tháng 6 năm 2019)
- bzip2 Format Description (Thư viện Quốc hội Hoa Kỳ, FDD000600)
- Ảnh đại diện: Jacek Halicki; Wikimedia Commons; CC BY-SA 4.0 (đã chỉnh sửa từ ảnh gốc)
