21/10/2026 · VietTechies · Biên tập
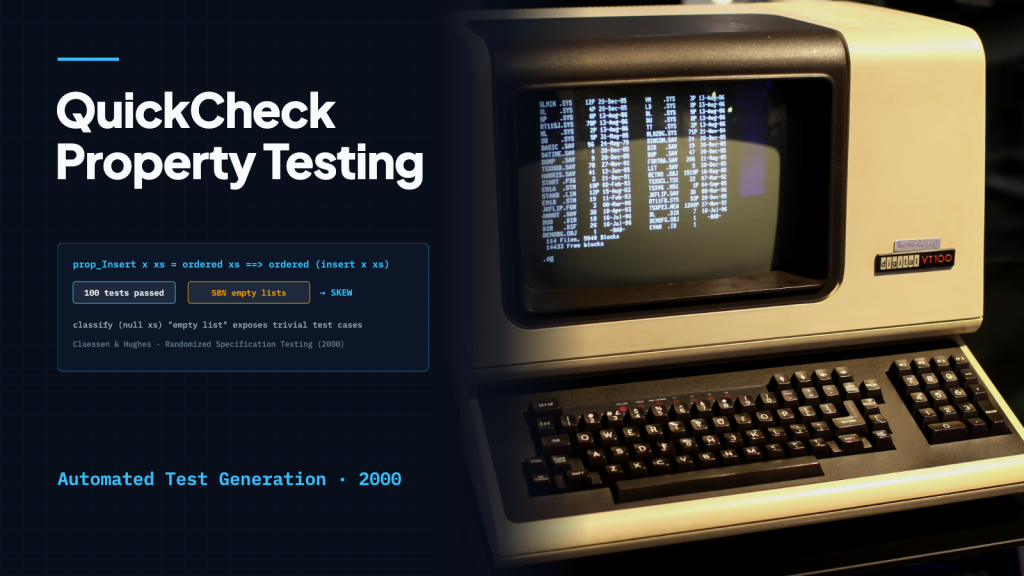
Cả 100 lần kiểm thử đều đạt. Nhưng 58% danh sách đầu vào lại rỗng. Trong tài liệu hướng dẫn QuickCheck ban đầu, ví dụ kiểm thử thao tác chèn vào danh sách đã sắp xếp cho thấy một vấn đề mà chỉ nhìn thông báo thành công thì không thể nhận ra: phần lớn trường hợp chương trình vừa xử lý đều rất dễ.
QuickCheck, được Koen Claessen và John Hughes giới thiệu trong bài báo năm 2000 về kiểm thử chương trình Haskell, đã tự động hóa việc tạo dữ liệu đầu vào cho kiểm thử. Tài liệu của công cụ này cũng chỉ ra vì sao lập trình viên vẫn cần xem những dữ liệu ấy gồm những gì.
Quyết định quan trọng ở đây là giao cho máy một thuộc tính cần kiểm tra, thay vì một đáp án mong đợi riêng cho từng ví dụ. Nhờ vậy, số lần kiểm thử có thể tăng lên nhiều. Nhưng cách chọn ví dụ cũng trở nên khó nhận thấy hơn, trừ khi có người chủ động xem xét.
Viết quy tắc, rồi sinh ví dụ
Thuộc tính mô tả một quan hệ mà hàm cần bảo toàn với các đầu vào. Chẳng hạn, đảo ngược một danh sách hữu hạn hai lần phải cho ra danh sách ban đầu. Lập trình viên có thể biểu diễn quan hệ đó bằng một hàm Haskell, còn QuickCheck cung cấp các danh sách sinh ngẫu nhiên để kiểm tra.
Tài liệu trình bày một lượt chạy trong đó thuộc tính này vượt qua 100 lần kiểm thử. Tài liệu cũng đưa ra một thuộc tính cố ý viết sai: đảo ngược danh sách một lần vẫn giữ nguyên danh sách đó. QuickCheck bác bỏ nhận định này bằng phản ví dụ [-3,15]. Đảo ngược danh sách gồm hai số khác nhau ấy sẽ làm đổi thứ tự của chúng.
Đây là những kết quả được in trong tài liệu, không phải các thí nghiệm thực hiện cho bài viết này. Đặt hai kết quả cạnh nhau sẽ thấy cách công cụ hoạt động: lập trình viên đưa ra một nhận định có thể kiểm tra, rồi công cụ tìm trong các ví dụ được sinh ra một trường hợp trái với nhận định ấy.
Vì thế, khi kiểm thử thất bại, cả hai phía đều có thể cần xem lại. Phần triển khai có thể sai, hoặc thuộc tính có thể mô tả một điều mà phần triển khai vốn không được yêu cầu phải làm.
Một điều kiện có thể âm thầm làm thay đổi mẫu thử
Hãy xét thao tác chèn một số vào danh sách đã sắp xếp. Một thuộc tính hữu ích là danh sách sau khi chèn vẫn phải có thứ tự. Nhưng nhận định này kèm một điều kiện: danh sách ban đầu cũng phải được sắp xếp.
Trước tiên, tài liệu biểu diễn điều kiện đó bằng cách lọc các danh sách được sinh ra. Danh sách chưa sắp xếp bị loại; danh sách đã sắp xếp được dùng để kiểm thử thao tác chèn. Quá trình sinh dữ liệu tiếp tục cho đến khi tìm đủ trường hợp đáp ứng điều kiện hoặc chạm giới hạn tổng thể.
Cách lọc ấy làm thay đổi mẫu thử. Danh sách rỗng và danh sách chỉ có một phần tử vốn đã đáp ứng điều kiện về thứ tự. Danh sách ngẫu nhiên dài hơn lại dễ bị loại hơn. Vì vậy, phần lớn công sức kiểm thử có thể dành cho thao tác chèn vào các danh sách rất ngắn.
Tài liệu cho thấy rõ sự mất cân đối này bằng cách thống kê độ dài danh sách. Trong mẫu được trình bày, 58% danh sách rỗng, 26% có một phần tử, 13% có hai phần tử và 3% có ba phần tử. Những tỷ lệ này mô tả mẫu trong tài liệu, không phải phân bố mà mọi lượt chạy QuickCheck đều phải tạo ra.
Kết hợp thống kê độ dài với việc phân loại còn cho thấy một khoảng trống khác: mẫu thử chưa kiểm tra thao tác chèn vào đầu hoặc cuối danh sách có nhiều hơn một phần tử. Thông báo thành công phản ánh đúng những trường hợp đã kiểm tra, nhưng cho biết rất ít về những trường hợp còn thiếu.
Sinh đầu vào phù hợp với điều cần kiểm tra
Tài liệu đưa ra một cách thay thế trực tiếp: sinh danh sách đã sắp xếp ngay từ đầu. Một bộ sinh dữ liệu (generator) được viết riêng sẽ cung cấp đầu vào phù hợp mà không cần sinh rồi loại bỏ những danh sách không đạt điều kiện.
Đây là một phần trong thiết kế của QuickCheck, không phải cách khắc phục nằm ngoài công cụ. Lập trình viên có thể dùng thư viện để định nghĩa generator và quan sát phân bố đầu ra. Bài báo gốc nêu rõ rằng người kiểm thử nắm quyền kiểm soát phân bố dữ liệu kiểm thử.
Sự phân biệt này quan trọng vì thuộc tính và bộ sinh dữ liệu đảm nhiệm hai việc khác nhau. Thuộc tính nêu điều phải đúng. Bộ sinh dữ liệu quyết định những tình huống thực sự được kiểm thử. Cải thiện một phía không tự động cải thiện phía còn lại.
Đặc tả cũng có thể cần sửa lỗi
Bài báo gốc của Claessen và Hughes mô tả một ví dụ về hợp nhất (unification), trong đó thuật toán tìm các phép thế để các biểu thức ký hiệu trở nên giống nhau. Hai tác giả cho biết họ tìm thấy lỗi trong đặc tả của thuật toán, dù không tìm thấy lỗi trong chính thuật toán hợp nhất.
Một thuộc tính được đề xuất liên quan đến việc áp dụng lặp lại một phép thế. Thuộc tính ấy cần thêm điều kiện loại trừ các phép thế có chu trình. Việc kiểm thử đã khiến hai tác giả sửa lại nhận định của mình về code.
Đó là một kết quả hữu ích khi biến điều mong đợi thành thứ có thể chạy để kiểm tra: một phản ví dụ có thể làm lộ ra chỗ hiểu sai trước khi người ta tự tin nhắc đi nhắc lại nó như một quy tắc.
Vượt qua một tập hữu hạn các phép kiểm thử ngẫu nhiên vẫn không xác lập được rằng thuộc tính đúng với mọi đầu vào có thể có. Bài hướng dẫn sau này của Joe Nelson nêu rõ giới hạn ấy. Hackage, danh mục các gói phần mềm Haskell, cũng cảnh báo rằng tài liệu hướng dẫn ban đầu đã có những phần lỗi thời, nên không thể xem các ví dụ trong đó là mô tả đầy đủ về thư viện hiện nay.
Số lần kiểm thử đạt chỉ cho biết đã kiểm tra bao nhiêu trường hợp, chứ không cho biết đó là những trường hợp nào. Trong ví dụ của tài liệu, 100 lần đạt dựa trên một mẫu có tới 58% danh sách rỗng. Vì thế, phân bố đầu vào cũng đáng được chú ý không kém kết quả kiểm thử.
Bài liên quan
Đọc bằng ngôn ngữ khác: English
Nguồn
- Koen Claessen và John Hughes: trang dự án QuickCheck ban đầu
- Tài liệu hướng dẫn QuickCheck ban đầu
- Claessen và Hughes: QuickCheck: A Lightweight Tool for Random Testing of Haskell Programs, ICFP 2000
- Joe Nelson: The Design and Use of QuickCheck, 2017
- Hackage: tài liệu gói QuickCheck
- Ảnh đại diện: Jason Scott; Wikimedia Commons; CC BY 2.0 (đã chỉnh sửa từ ảnh gốc)
