
16/10/2026 · VietTechies · Biên tập
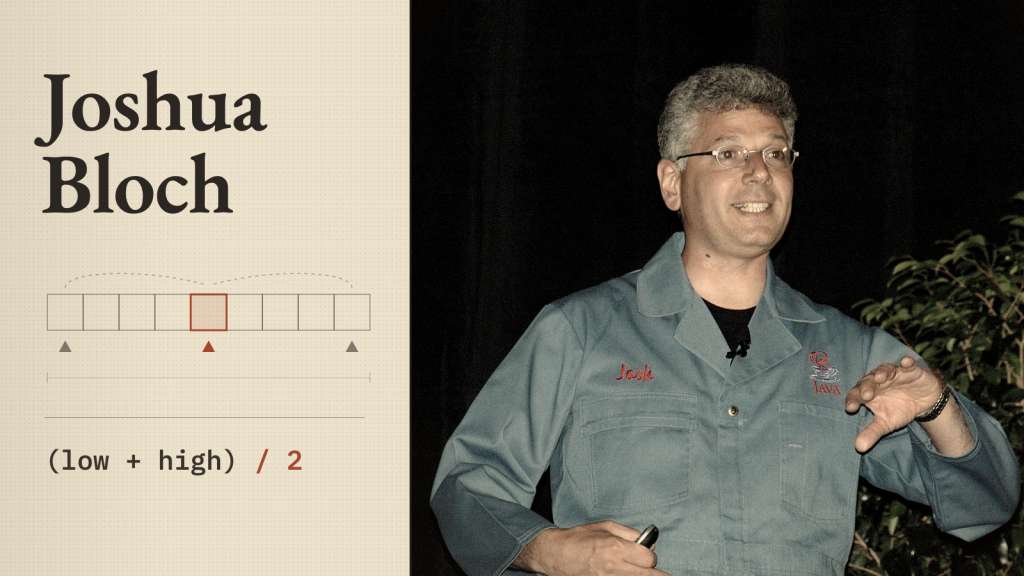
Tháng 6 năm 2006, trên blog nghiên cứu của Google, Joshua Bloch thừa nhận rằng hàm tìm kiếm nhị phân (binary search) mà ông viết cho thư viện chuẩn của Java có một bug. Ông còn cho biết một điều đáng lo hơn. Bản tìm kiếm nhị phân mà Jon Bentley từng chứng minh là đúng trong cuốn sách Programming Pearls của mình cũng mắc đúng bug ấy.
Ở cả hai phiên bản, bug nằm ở dòng code tính điểm giữa của khoảng tìm kiếm còn lại, tức đoạn từ chỉ số low đến chỉ số high. Trong bài của Bloch, dòng này viết như sau:
int mid = (low + high) / 2;
Trên giấy, dòng này chẳng có gì sai. Nhưng trong Java, low và high là số nguyên 32 bit, mà kiểu int thì không chứa được giá trị nào lớn hơn 2.147.483.647. Với một mảng có hơn 1.073.741.824 phần tử — tức 2 mũ 30 — tổng low + high có thể vượt quá giới hạn ấy. Khi đó tổng sẽ quay vòng thành một số âm, và thuật toán đòi truy cập một phần tử ở chỉ số âm.
Bloch viết rằng bug đã được báo cho Sun Microsystems, công ty phát triển Java thời đó, “khi nó làm hỏng chương trình của ai đó, sau khi đã nằm phục chừng chín năm.” Trong tiêu đề bài viết, ông nêu một kết luận rộng hơn: gần như mọi bản tìm kiếm nhị phân và sắp xếp trộn (mergesort) đều hỏng.
Bài học Bloch từng được Bentley dạy
Bentley thừa hiểu tìm kiếm nhị phân dễ sai đến mức nào. Bài của Bloch dẫn lời Bentley về lịch sử của thuật toán này: dù bản tìm kiếm nhị phân đầu tiên được công bố từ năm 1946, “phải đến năm 1962 mới xuất hiện bản tìm kiếm nhị phân đầu tiên chạy đúng với mọi giá trị của n.” Còn phần lịch sử thuật toán do Donald Knuth viết thì ghi nhận D. H. Lehmer đã có một bản như thế vào năm 1960. Bản của chính Bentley trong Programming Pearls có kèm chứng minh, và ông cũng đã kiểm thử bản này.
Bloch cũng từng học bài học ấy trực tiếp từ Bentley. Trong buổi giảng đầu tiên của môn thuật toán tại Đại học Carnegie Mellon, Bentley yêu cầu các nghiên cứu sinh tiến sĩ khóa mới, trong đó có Bloch, viết một hàm tìm kiếm nhị phân, rồi đem một bài làm của họ ra mổ xẻ ngay trước lớp. Bloch nhớ lại rằng bài làm đó có lỗi, “cũng như phần lớn các bản cài đặt của chúng tôi.”
Một mảng byte đã làm lộ bug ra sao
Trên một mảng đã sắp xếp, tìm kiếm nhị phân so sánh giá trị cần tìm với phần tử ở giữa rồi bỏ đi nửa mảng không thể chứa giá trị đó, nên ngay cả với một tỷ phần tử, thuật toán cũng chỉ cần khoảng 30 lần chia đôi.
Một báo cáo trong cơ sở dữ liệu lỗi của Sun, gửi ngày 11 tháng 5 năm 2004, cho thấy muốn kích hoạt bug này cũng chẳng cần gì nhiều. Bài kiểm thử tạo một mảng byte gồm 1.100.000.000 phần tử, gán giá trị 1 cho phần tử cuối cùng rồi tìm giá trị ấy. Mỗi bước đều đẩy low lên cao hơn, cho tới khi low + high vượt giới hạn của int. Lúc đó, bản beta của Java 5 ném ra ngoại lệ ArrayIndexOutOfBoundsException tại chỉ số −1.064.671.149.
Bài kiểm thử này không dùng đến phần cứng gì đặc biệt. Máy tính chạy Linux 32 bit, và Java được cấp vùng nhớ heap tối đa 1.200 megabyte. Một mảng byte gồm 1,1 tỷ phần tử cần khoảng 1,1 gigabyte.
Code trong thư viện thời đó hơi khác với dòng mà Bloch dẫn trong bài: nó dùng phép dịch bit thay cho phép chia, (low + high) >> 1, và cũng bị tràn số (overflow) y hệt. Người báo lỗi đề xuất cách sửa là phép dịch không dấu, viết là >>>, đồng thời lưu ý rằng lớp TreeMap cũng tính điểm giữa bằng đúng phép cộng có lỗi đó.
Báo cáo lỗi có trước bài blog
Báo cáo năm 2004 chưa được giải quyết suốt gần hai năm. Ngày 12 tháng 4 năm 2006, Martin Buchholz, kỹ sư được giao xử lý báo cáo đó, lập một báo cáo mới cho cùng vấn đề; bản mới này bị đóng vì trùng lặp, và đây chính là bản mà Bloch dẫn link trong bài. Ngày 28 tháng 4, Sun đánh dấu bug đã được sửa trong Java 6, ở build 83, tức khoảng năm tuần trước khi Bloch đăng bài.
Như vậy, Bloch không phải người phát hiện ra lỗi này. Việc ông làm trong bài viết là giải thích bug, thừa nhận phần trách nhiệm của chính mình và chỉ ra bug ảnh hưởng rộng tới đâu: “Bug trong tìm kiếm nhị phân cũng xảy ra y như vậy với mergesort, và với các thuật toán chia để trị khác.”
Vì sao chứng minh của Bentley không bắt được lỗi tràn số
Trong bản của Bentley, hai chỉ số mang tên l và u, và ông mô tả bằng lời nhiệm vụ của dòng tính điểm giữa: dòng này “gán cho m trung bình cộng của l và u, làm tròn xuống số nguyên gần nhất.” Với số nguyên trong toán học, dòng này làm đúng như thế. Còn với int 32 bit, nó chỉ làm được như thế chừng nào tổng l + u còn nằm gọn trong một int.
Khi Programming Pearls được viết, những mảng đủ lớn để làm tổng ấy tràn số là thứ mà Bloch gọi là “không thể tưởng tượng nổi hồi thập niên 80.” Ông viết rằng đến năm 2006, những mảng như thế đã phổ biến ở Google và những nơi khác. Chứng minh vẫn không đổi. Còn các mảng thì đã lớn vượt khỏi phạm vi của chứng minh ấy.
Hai cách sửa, và một cách sửa phải sửa lại
Bloch đưa ra hai cách sửa cho Java. Cách thứ nhất tránh hẳn việc cộng ra một tổng lớn:
int mid = low + ((high - low) / 2);
Cách thứ hai vẫn giữ phép cộng, nhưng đọc tổng đó theo kiểu khác:
int mid = (low + high) >>> 1;
Toán tử >>> của Java đẩy bit 0 vào từ bên trái, nên toán tử này coi 32 bit của một tổng đã tràn là một số không dấu. Tổng của hai chỉ số hợp lệ luôn nhỏ hơn 2 mũ 32, vì vậy kết quả chính là điểm giữa cần tìm. Code của OpenJDK hiện nay — tức bộ mã nguồn mở của Java — dùng đúng dạng này.
Riêng cách sửa dành cho C và C++ thì chính nó cũng phải sửa lại. Gợi ý đầu tiên của Bloch cho hai ngôn ngữ này không chắc sẽ chạy đúng theo C99, phiên bản năm 1999 của chuẩn ngôn ngữ C, vì chuẩn này không định nghĩa kết quả khi một số nguyên có dấu bị tràn. Trong một bản cập nhật năm 2008, Bloch ghi nhận công phát hiện của Antoine Trux ở Nokia Research Center và thay gợi ý cũ bằng một phiên bản khác, trong đó hai chỉ số được cộng với nhau dưới dạng số nguyên không dấu.
Bug này cho thấy gì về chứng minh và quy mô
Chứng minh chỉ bảo đảm cho mô hình của nó, không bảo đảm cho cỗ máy. Lập luận của Bentley đúng với những số nguyên không bao giờ chạm trần. Kiểu int của Java chạm trần ở 2.147.483.647. Trên giấy, “trung bình cộng của l và u” lúc nào cũng tồn tại. Còn trong một int 32 bit, tổng l + u có thể vượt quá sức chứa.
Quy mô biến những giả định an toàn thành bug. Dòng tính điểm giữa vô hại với mọi mảng có tối đa khoảng một tỷ phần tử. Những phép tính chỉ số vốn an toàn với kích thước mảng hôm nay vẫn có thể tràn số với kích thước của ngày mai.
Một bài kiểm thử chỉ kiểm được những đầu vào mà nó chạy qua. Bentley cũng đã kiểm thử chương trình của mình, vậy mà bug vẫn lọt qua cả chứng minh lẫn kiểm thử. Chính Bloch kết luận thẳng thừng: “Chỉ chứng minh một chương trình là đúng thôi thì chưa đủ; bạn còn phải kiểm thử nó nữa.” Để làm lỗi lộ ra, báo cáo năm 2004 cần vài dòng code và nhỉnh hơn một gigabyte bộ nhớ.
Bản sửa cuối cùng trong Java nhỏ xíu. Dòng code hỏng hồi năm 2004 viết là (low + high) >> 1. Còn trong OpenJDK ngày nay, ở một lớp vẫn ghi tên Bloch trong danh sách tác giả, dòng đó viết là (low + high) >>> 1: thêm đúng một ký tự, đánh dấu khác biệt giữa số nguyên của một chứng minh và số nguyên của một cỗ máy.
Bài liên quan
Đọc bằng ngôn ngữ khác: English
Nguồn
- Joshua Bloch, “Extra, Extra – Read All About It: Nearly All Binary Searches and Mergesorts are Broken,” Google Research Blog, ngày 2 tháng 6 năm 2006 (kèm bản cập nhật năm 2008)
- Báo cáo lỗi JDK-5045582 của OpenJDK, “(coll) binarySearch() fails for size larger than 1<<30,” gửi ngày 11 tháng 5 năm 2004, được giải quyết ngày 28 tháng 4 năm 2006
- Báo cáo lỗi JDK-6412541 của OpenJDK, “Arrays.binarySearch does not work for arrays larger than 1<<30,” gửi ngày 12 tháng 4 năm 2006
- Mã nguồn OpenJDK, java.util.Arrays (phiên bản hiện tại)
- Wikipedia, “Binary search”
- Ảnh đại diện: Joshua Bloch tại JavaOne 2005, tác giả Billy Bob Bain, qua Wikimedia Commons, CC BY 2.0
